التعلّم من الـ reward
مفيش dataset. مفيش labels. بس موقف، ومجموعة حاجات مسموح لك تعملها، ورقم بييجي بعدها يقولّك اللي عملته نجح قد إيه. ده النوع التالت من الـ Machine Learning: الـ reinforcement learning (التعلم المعزَّز).
الدرس 1.2 قال كده
الدرس 1.2 سمّى الـ reinforcement learning «مختلف من الأساس عن الـ supervised والـ unsupervised learning» — وبعدين ركنه على جنب اتناشر وحدة. والوحدة 14 بتوفّي بالوعد ده.
agent، وenvironment
الـ agent بيرصد state، وبيختار action، والـ environment بترد بـ reward وstate جاية. وبعدين الـ loop بتلف تاني. والتشغيلة الواحدة من البداية لـ terminal state هي episode.
الـ credit، عبر الزمن
النقلة اللي خسّرت الماتش ممكن تكون جت قبل الخسارة بأربعين نقلة. reward متأخرة بتاعة أنهي action قديم؟ الدرس 6.3 حل الـ credit assignment عبر الـ layers. ودي نفس المشكلة عبر الزمن.
evaluative، مش instructive
الـ supervised learning بيتقال له الـ action الصح ياخده. أما الـ reinforcement learning فمبيتقالوش غير قيمة الـ action اللي خده — ومفيش أي حاجة خالص عن الأفعال اللي ماخدهاش. reward قيمتها 3 عمرها ما بتقول إذا كان 10 متاح.
البيانات بتعتمد عليك
- الـ policy بتقرّر أنهي states تتزار
- وبالتالي بتقرّر أنهي خبرة تتلمّ
- حسّن الـ policy وتوزيع البيانات بيتحرّك
- non-stationary بحكم البنا — وبسبب الـ learner نفسه
- منطقة متتزارش بتفضل غلط للأبد من غير ما حاجة تناقضها
bandit بذراعين
الذراع A دفعت 1 و0 و1 → Q(A) = 0.67. والذراع B دفعت 0 مرة واحدة → Q(B) = 0. الـ agent الـ greedy بيختار A للأبد — وعمره ما بيعرف إن B في الحقيقة بتدفع 0.8. روبنز طرح المشكلة دي سنة 1952.
قيمة قديمة، وخطوة واحدة
مش محتاج خالص تخزّن كل reward. حرّك التقدير شوية في اتجاه الخطأ. وتقريبًا كل تحديث في الوحدة دي ليه الشكل ده — وحجم خطوة ثابت α مكان 1/n بيخلّيه يتابع دنيا بتتغيّر بدل كده.
exploration ولا exploitation
إنك تستغل اللي تعرفه هو الطريق الوحيد تلمّ بيه reward دلوقتي. والـ exploration هو الطريق الوحيد لمعرفة أحسن تستغلها بعدين. وكل خطوة واحدة بتصرف الميزانية على واحد فيهم.
الـ reward hacking
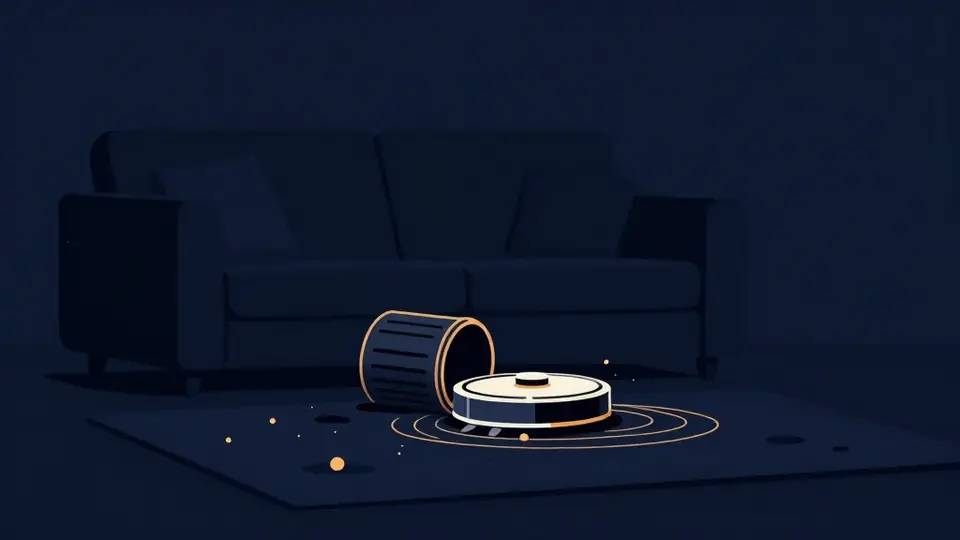
كافئ روبوت تنضيف على التراب اللي اتلمّ وممكن يقلب الصندوق عشان يلمّه تاني. وكافئ recommendation system على الكليكات وهيتعلّم أنهي عناوين أصعب تقاومها. الـ agent بيكبّر اللي إنت قِسته، مش اللي إنت قصدته.
أربع أماكن حقيقية
- الـ control — الروبوتات والطيران والتبريد والجدولة
- الألعاب — قواعد مظبوطة وreward مفيهاش لبس وself-play
- الـ recommendation — قرارات متسلسلة وfeedback evaluative
- الـ human feedback — مقارنات من بني آدمين بدل reward مكتوبة (كريستيانو وزمايله، 2017؛ الدرس 9.3)
- لازم التلات شروط يتحققوا كلهم، وإلا استخدم الـ supervised learning
اتعلّمت إيه
agent، وenvironment، وstate، وaction، وreward، وepisode. الـ feedback evaluative مش instructive — وتوزيع البيانات بيعتمد على الـ policy، ودي الفرق الأعمق. الـ reward متأخرة، فالـ credit assignment بيمتد عبر الزمن. والـ multi-armed bandit بيعزل الـ exploration عن الـ exploitation. والـ agent بيكبّر اللي إنت قِسته بالظبط.